Deine Projekte bekommen ein Nervensystem, gebaut wie ein lebendes.
Ein Sprachmodell liest, was man ihm gibt, und behält nichts, sobald das Gespräch endet. Lebende Nervensysteme lösen das in Schichten: Sinne, die nie abschalten, ein Gedächtnis, das den richtigen Moment findet, Reflexe, die eine Antwort vorbereiten. AUVY ist aus denselben Schichten gebaut, oben entscheidet ein Mensch, und es behält jedes Wort, das ein Gehirn fallen ließe.
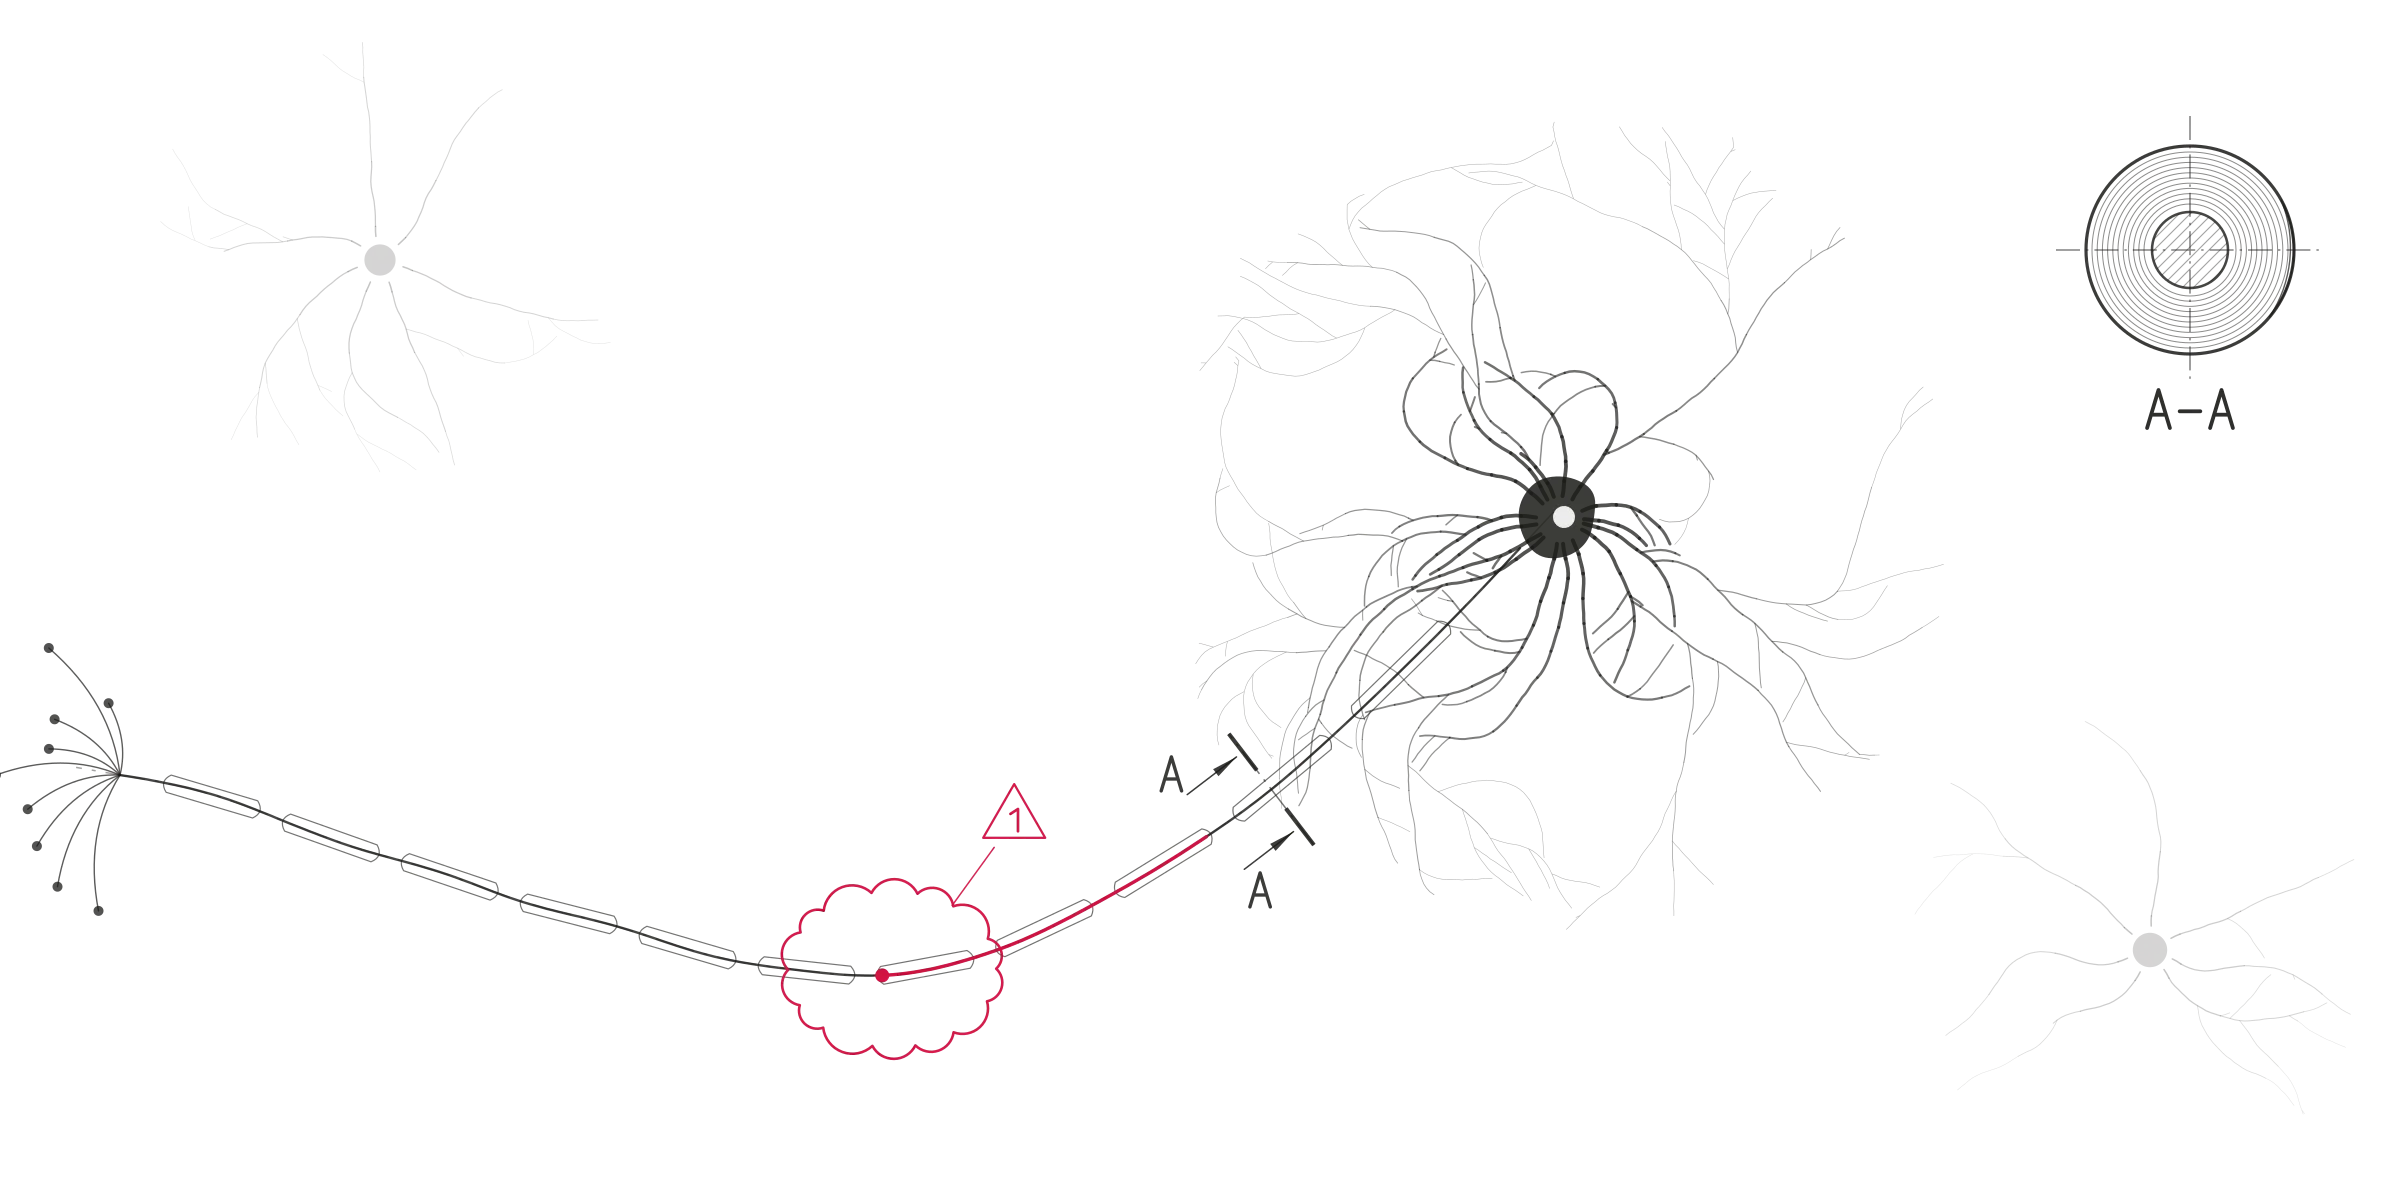
Zeichnung: eine Nervenzelle und ihre Äste.
Ein ganzes Nervensystem
Erst das ganze System, im echten Projekt.
1991 plädierte der Robotiker Rodney Brooks dafür, vollständige Systeme zu bauen, die von Anfang an in der echten Welt handeln, in Schichten, die jede für sich funktionieren, und sie mit der Zeit fähiger zu machen. Die KI-Forschung hatte das Problem damals in einzelne Planer und Gedächtnisse zerlegt und in vereinfachten Welten getestet. Nervensysteme sind auf seine Art gewachsen, und AUVY ist auf seine Art gebaut.
- SinneMails, Einladungen, Besprechungsnotizen und geänderte Dateien kommen hier zuerst an. Jedes Stück wird gelesen, datiert und seinem Projekt zugeordnet, sobald es eintrifft.
- GedächtnisAlles, was das Projekt bekommen hat, wörtlich und mit Quelle. Eine Frage findet es über ein Datum, eine Person oder das, was gemeint war.
- Vorbereitete SchritteÄndert sich etwas, ermittelt AUVY, was es betrifft, und entwirft den Schritt: eine Antwort an den Kunden, eine Aufgabe, einen neuen Termin im Plan.
- Ein Mensch entscheidetJeder Entwurf hält hier an. Jemand nimmt ihn an, ändert oder verwirft ihn, und erst dann geht er raus.
Baue etwas Einfaches und Vollständiges, setze es früh in die echte Welt und baue dort weiter.
AUVY arbeitet vom ersten Tag an mit den echten Mails und Dateien eines Projekts, mit allen Weiterleitungen, Anhängen und offenen Threads. Jede neue Fähigkeit kommt oben drauf.
Viele einfache Schichten, kein zentrales Modell. Eine höhere Schicht übernimmt eine untere nur dort, wo sie muss.
Bemerken, Behalten und Entwerfen sind getrennte Schichten. Ist das Entwerfen abgeschaltet, wird das Projekt trotzdem bemerkt und behalten.
Die Welt ist ihr eigenes bestes Modell.
Eine Antwort zitiert die Mail und die Dateiversion, die sie gelesen hat. So kann jeder sie an der Quelle prüfen.
Die untersten Schichten bleiben schnell und laufen immer.
Neue Mails werden weiter eingeordnet, während jemand einen Entwurf prüft. Nichts wartet hinter einem langsamen Schritt.
Wie es findet
Was das Gehirn tut, um eine Erinnerung zu finden, und was AUVY davon übernimmt.
Dein Gehirn lässt die meisten Details fallen, findet aber erstaunlich gut genau das eine, was du brauchst, über ein Datum, einen Ort, einen Namen oder einen halben Satz. Die Gedächtnisforschung beschreibt, wie es das macht. Das sind die Vorgänge, je ein Ring, und was AUVY daraus baut. Die Details, die das Gehirn verlieren würde, behält AUVY.
- Ein Fakt, eine Spur
Im Gehirn: Zwei ähnliche Besprechungen bleiben zwei Erinnerungen. Sie verschwimmen nicht zu einer.
In AUVY: Mails und Dateien werden in kleine Stücke geteilt, ein Fakt pro Stück, damit eine Suche genau die Stelle trifft, die ihn enthält.
- Wann und wo
Im Gehirn: Oft findest du eine Erinnerung über den Tag oder den Raum, in dem es passiert ist.
In AUVY: Jede Stelle kennt ihr Datum und ihren Ort. Fragst du nach letzter Woche oder nach einem Ordner, sucht AUVY zuerst dort.
- Personen und Beziehungen
Im Gehirn: Du weißt, wer mit wem arbeitet, ohne dich zu erinnern, woher du es weißt.
In AUVY: AUVY baut aus dem Gelesenen eine Karte von Personen, Firmen und Besprechungen auf, jede Verbindung belegt durch den Satz, der sie nennt. Eine Frage zu jemandem wird diesen Verbindungen folgen.
- Vom Bruchstück zum Ganzen
Im Gehirn: Ein Geruch oder ein halber Satz holt die ganze Szene zurück.
In AUVY: Findet eine Suche eine Stelle, liest AUVY auch den Abschnitt oder Thread drumherum, damit hinter der Antwort das ganze Gespräch steht.
- Über Nacht einordnen
Im Gehirn: Im Schlaf geht das Gehirn den Tag noch einmal durch und ordnet ein, was wichtig war.
In AUVY: Im Hintergrund wird AUVY aus neuen Mails und Besprechungsnotizen kurze Fakten und Zusammenfassungen machen, die eine Suche findet, jede mit Verweis auf das Original.
- Der neuere Fakt zuerst
Im Gehirn: Erfährst du, dass sich etwas geändert hat, tritt die neue Fassung an die Stelle der alten.
In AUVY: Ändert sich ein Termin oder ein Preis, wird die neueste Aussage unter den Stellen zur selben Sache zuerst kommen, die alte bleibt belegt. Die rote Wolke in der Zeichnung markiert diese Änderung.
- Was zuerst einfällt
Im Gehirn: Was du oft brauchst, fällt dir zuerst ein. Was du nie brauchst, tritt zurück und ist irgendwann weg.
In AUVY: Stellen, die niemand nutzt, werden etwas tiefer rangieren, wenn zwei sonst gleich gut sind. Gelöscht wird keine.
- Wissen, was man nicht weiß
Im Gehirn: Du merkst, wenn du etwas nicht weißt, und sagst es.
In AUVY: Steht die Antwort nicht in den Quellen, sagt AUVY, dass es nichts gefunden hat, und markiert jeden Satz, den es nicht mit einer Quelle belegen kann.
- Jenseits des Gedächtnisses
Im Gehirn: Aufmerksamkeit, Vorhersage, Planung, Handeln.
In AUVY: Sobald das Finden trägt, gehen wir den Rest des Gehirns genauso an. In Strich-Zweipunkt-Linien gezeichnet: geplant.
Ergebnisse
Vier öffentliche Benchmarks, kein fremdes Modell in der Suche.
Sie prüfen, ob in einem langen Verlauf die richtige Stelle gefunden wird und ob die Antwort daraus stimmt. Sie nutzen Chatverläufe; AUVY liest Projektmails und Dateien, die Aufgabe ist dieselbe.
| Benchmark | Was er testet | Anzahl | AUVY | Andere Systeme |
|---|---|---|---|---|
| Finden | ||||
| LongMemEval-S | Das Gespräch finden, das die Antwort enthält, unter etwa 50 pro Frage | 500 | 99,4Höchster Wert |
|
| LoCoMo | Die Sitzung finden, die die Antwort enthält, in zehn Gesprächen über Monate | 1.540 | 94,9 | – |
| Antworten | ||||
| MemConflict | Antworten, wenn gespeicherte Fakten sich widersprechen | 3.750 | 70,4Höchster Wert |
|
| LongMemEval-S | Aus rund 115.000 Tokens Chatverlauf antworten | 500 | 91,8 |
|
| LoCoMo | Fragen zu denselben zehn Gesprächen beantworten | 1.540 | 91,8 |
|
| BEAM 1M | Zehn Gedächtnisfähigkeiten über Gespräche von rund einer Million Tokens | 700 | 62,4 |
|
Finden: die richtige Quelle unter den ersten fünf Treffern. Antworten: Anteil richtig, bewertet so, wie die anderen Systeme berichten: LongMemEval mit seinen eigenen Judge-Prompts, LoCoMo mit dem veröffentlichten Prompt von Mem0, MemConflict als Mittel über die drei Konfliktarten. BEAM: Nugget-Score von 0 bis 100, Judge-Prompt von Mem0; alles andere in Prozent. Andere Systeme so, wie sie veröffentlichen, jeweils mit eigenem Antwortmodell; ein Strich, wo niemand dasselbe Maß veröffentlicht.
Offene Probleme
Woran wir als Nächstes arbeiten.
Wo die Zahlen Luft lassen, und welcher Teil der Methode dort ansetzt.
- Jede Quelle, nicht nur eine
- Die Suche findet fast immer eine Quelle, die eine Antwort braucht, aber nicht immer jede. Am meisten verlieren Fragen, die mehrere Gespräche verbinden. Hier setzt „Über Nacht einordnen“ an.
- Zeit und Veränderung
- Fragen zum neueren von zwei Fakten, zu Zeit und zur Reihenfolge von Ereignissen schneiden am schwächsten ab, ebenso Fakten, die sich nicht hätten ändern dürfen. Hier setzt „Der neuere Fakt zuerst“ an.
- Große Firmenarchive
- EnterpriseRAG-Bench stellt 500 Fragen über rund eine halbe Million Firmendokumente, Mails und Chatnachrichten. Mit einer einfacheren Konfiguration der Suche erreicht AUVY 34,4, der oberste Eintrag im Leaderboard, Mixedbread mit Opus 5, 86,6. In einem reinen Suchlauf fand AUVY 36,4 % der Dokumente, die die Antworten brauchten; die Arbeit liegt also in der Suche.
Methode
Wie die Zahlen entstanden sind.
- Was lief
- Der Dokumentenspeicher und die Suche von AUVY, auf einem eigenen Benchmark-Stack ohne Kundendaten. Jeder Benchmark hatte einen eigenen Workspace und einen eigenen Index.
- Läufe
- Ein vollständiger Lauf pro Benchmark und Modell. Jede Frage zählt; keine wurde weggelassen oder wiederholt.
- Suche
- Hybride Stichwort- und Vektorsuche mit dem Mischen und Reranking wie oben beschrieben. BEAM und EnterpriseRAG liefen mit einer einfacheren Konfiguration derselben Suche. In keinem der gezeigten Läufe ein externes Reranking-Modell.
- Leser und Judges
- LongMemEval, LoCoMo und MemConflict: GPT-6 Luna liest und bewertet, der Leser mit hohem Reasoning-Aufwand. BEAM: GPT-5.6 Luna für beides.
- Judge-Prompts
- LongMemEval und MemConflict mit ihren eigenen Prompts. LoCoMo und BEAM mit dem Prompt, den Mem0 veröffentlicht; so berichten die anderen Systeme, damit die Werte nebeneinander stehen können.
- Keine Regeln pro Frage
- Die Anweisungen an den Leser nennen keine Benchmark-Frage und keine Antwort.
- Veröffentlichte Zahlen
- Aus den Berichten der Anbieter. Wir haben sie nicht nachgerechnet. Unser Benchmark-Harness ist nicht öffentlich.
Benchmarks und veröffentlichte ErgebnisseLongMemEval ↗LoCoMo ↗BEAM ↗MemConflict ↗EnterpriseRAG-Bench ↗Mem0 research ↗gbrain-evals ↗
Fragen dazu
Trainiert ihr KI-Modelle mit unseren Daten?
Nein. AUVY bestimmt keine Kundendaten für das Training von Modellen.
Datenverarbeitung ↗Kann das ganze Team in einem Projekt arbeiten?
Ja. Das Team teilt ein Projekt: dasselbe Bild, gemeinsame Gespräche mit AUVY und Dokumente, die live zusammen bearbeitet werden. Persönliche Notizen bleiben persönlich.
Wie prüfe ich, was AUVY mir sagt?
Jede Antwort zeigt ihre Quelle: Datei und Version, die sie gelesen hat, einen Klick entfernt. Hat ein Satz keine Quelle, nennt AUVY ihn.
Dateien →Wer bei AUVY kann unsere Daten sehen?
Nur Personen in eurem Workspace, nach Workspace-Rollen, und AUVY-Mitarbeitende, die den Dienst betreiben müssen, mit begrenztem Produktionszugriff für Support und Betrieb.